机器学习 Machine Learning
- 课程性质
- 研究生课程
- 上课安排
- 周一下午 · 09/14—11/02
- 先修要求
- 线性代数、概率论、多元微积分
https://kaizhao.net/teaching/shu-ml-grad
全部课件在此发布,可在线放映,也可导出 PDF。
考核方式
平时成绩 50%
考勤10%
presentation30%
QA10%
开卷考试50%
可带教材与笔记
各项比例均占总成绩;QA(Questions and Answers)为问答环节。
课程安排
2026 年秋季 · 周一下午 · 7 次到课(含考试)
| 日期 | 课堂安排 |
|---|
| 09/14 | 教师讲授 3 节 + 分组 1 节 |
| 09/21 | 教师讲授 2 节 + 4 组汇报 2 节 |
| 09/28 | 教师讲授 2 节 + 4 组汇报 2 节 |
| 10/05 | 国庆节放假 · 停课一次 |
| 10/12 | 教师讲授 2 节 + 4 组汇报 2 节 |
| 10/19 | 教师讲授 2 节 + 4 组汇报 2 节 |
| 10/26 | 教师讲授 2 节 + 4 组汇报 2 节 |
| 11/02 | 4 组汇报 90 分钟 + 考试 2 小时 |
学生汇报
每组控制在 15 分钟
其中 10 分钟 PPT 汇报,剩余时间提问交流
填写分组信息
加入课程微信群
每节课 45 分钟;11/02 的开卷考试为完整 2 小时。
学生汇报要求
结合组员兴趣与研究方向,选取近五年的一篇交叉领域研究型论文:
机器学习 × 感兴趣的研究方向;不接受综述论文。
时间安排:每组 15 分钟,其中 10 分钟 PPT 汇报,剩余时间提问交流。
① 应用背景
实际问题是什么?为什么值得解决?
用一个具体场景说明研究动机。
② 任务与学习方式
输入 → 输出:分类、回归、聚类或决策。
有监督、无监督或强化学习:训练信号从哪里来?
③ 模型如何工作
用一个样本走完:输入 → 关键步骤 → 输出。
解释模型的核心机制与设计理由。
例如:卷积神经网络、支持向量机、Transformer。
④ 结果与自己的理解
与什么方法比较?改善了什么?
选取关键结果,说明适用条件与局限。
费曼学习法:用自己的话,从具体例子讲起,先解释必要术语。
讲解的标准:没有该领域背景的研一同学也能听懂。
任课教师
赵 凯 Kai Zhao
上海大学 · 副教授
kz@kaizhao.net
机器学习计算机视觉
教育背景
2017—2020
南开大学 计算机科学与技术 博士 · 导师 程明明 教授
2014—2017
上海大学 硕士 · 导师 沈为 教授
工作经历
2022.03—2025.07
加州大学洛杉矶分校(UCLA) 博士后
2020.10—2022.02
腾讯优图实验室 高级研究员 · 校招 T9 技术专家
2018.09—2019.01
松下研发中心(新加坡) 研究实习
课程内容
- 1机器学习基本概念
- 2学习问题的形式化
- 3模型评估与选择
- 4有监督学习:线性回归
- 5线性分类:判别分析与多分类学习
- 6决策树
- 7贝叶斯分类器
- 8支持向量机与核方法
- 9无监督学习:聚类与 EM 算法
- 10神经网络与特征提取
- 11特征降维与表示
- 12图像的无标注预训练
- 13语言模型的无标注预训练
第 1 讲
机器学习基本概念
基本概念、发展历程与应用领域
概念与模型 · 发展历程 · 学习方式与工具 · 应用领域
本讲内容
- 概念与模型:输入、输出与待学习的参数
- 发展历程:学习程序、统计学习、深层网络与预训练
- 学习方式与工具:训练信号与编程流程
- 应用与适用边界:数据领域、典型案例与适用条件
机器学习的定义
朴素的说法
机器学习是从数据中确定规则的方法。
人规定候选规则的范围与评判优劣的标准,
程序依据数据确定具体的规则,并用于处理未见过的输入。
| 人给什么 | 机器给什么 |
|---|
| 传统编程 | 规则 | 处理结果 |
| 机器学习 | 数据 + 标准 | 规则 |
一般程序 · 规则驱动
vs
机器学习程序 · 数据驱动
Mitchell 的形式定义(1997)
一个程序在完成任务 T 时,其由指标 P 度量的性能,
随着经验 E 的积累而改善,则称该程序就 T 和 P 而言,从 E 中学习。
| 垃圾邮件过滤 |
|---|
| T 任务 | 把邮件判为垃圾/正常 |
| P 指标 | 判对的比例 |
| E 经验 | 用户标记过的历史邮件 |
该定义使"学习"成为可测量的对象:缺少 P 则无法判定是否发生了学习。
边界:判据只有一条
把程序的行为拆成人写死的代码和从数据里定出来的参数两部分。
后者存在,而且对行为起决定作用 —— 就是机器学习。
| 程序 | 是否 ML | 为什么 |
|---|
| 快速排序 | 否 |
行为完全由代码决定,与所见数据无关 |
| 用高斯消元解线性方程组 | 否 |
精确算法,答案由输入唯一确定,没有"参数"可言 |
风控规则库:if 月收入<5000 and 逾期次数>2: 拒绝 | 否 |
阈值由业务专家设定;改变行为需修改代码 |
| 同一套风控,但阈值由历史坏账数据拟合而来 |
是 |
代码不变,数据改变则行为改变 |
| 统计每个词在垃圾邮件中的出现频率,据此打分 |
是 |
朴素贝叶斯(naive Bayes)。参数就是数据的统计量(第 7 讲) |
| 人工整定参数的 PID 控制器 | 否 | 参数由人工整定 |
| 数据库查询优化器,代价模型是人写的公式 | 否 | — |
| 同一个优化器,代价模型从执行历史学出来 |
是 | — |
后四行两两成对:任务与代码结构相同,差别仅在于参数的来源。
房价预测:模型与参数
●训练房屋
▲测试房屋
◆当前预测
曲面高度与颜色:预测总价
$\hat y=\sum_{i+j\le n}w_{ij}x_1^i x_2^j=W^\top X$
次数 $n$:人工设定;系数 $w_{ij}$:从训练数据学习
机器学习的发展历程

年份间距为示意;上升表示方法与应用的发展。
1950 年代:从经验中调整规则
Frank Rosenblatt · 1958
感知机(perceptron):学习分类权重
Arthur Samuel · 1959
跳棋程序:学习局面评分

1986—1995:表示学习与统计学习
反向传播 · 1986
Rumelhart · Hinton · Williams
支持向量机 · 1995
Cortes · Vapnik

2006—2012:深层网络与图像识别
Hinton · Osindero · Teh:深度信念网络的逐层预训练

AlexNet:Krizhevsky · Sutskever · Hinton,2012
A fast learning algorithm for deep belief nets (2006) · ImageNet Classification with Deep Convolutional Neural Networks (2012)
2017—2022:注意力与无标注预训练
Vaswani 等:Transformer,2017 · 用数据自身构造学习目标

Attention Is All You Need (2017) · BERT (Devlin et al., 2018/2019) · Masked Autoencoders (He et al., 2021/2022)
学习方式与训练信号
有监督学习
supervised learning面积 · 距离↓ 配对成交总价
给定输入与标签 $(x,y)$
学习输入到输出的映射
无监督学习
unsupervised learning给定数据 $x$
发现结构、分组或表示
强化学习
reinforcement learning智能体 → 动作 → 环境↑ 奖励与新状态 ↲
通过交互获得奖励
学习长期回报更高的策略
分类 / 回归描述预测任务;有监督 / 无监督 / 强化描述学习方式。
回归与分类
同一套房屋的特征 $x$:面积、位置、户型……
回归 regression
连续数值:预测数值大小
输出 $y$:一个数值
分类 classification
离散类别:判断类别归属
输出 $y$:一个类别标签
按预测目标 $y$ 划分任务;回归与分类都可以用有监督学习完成。
自监督学习:从数据自身获得目标
自监督学习(self-supervised learning)
原始文本今天的天气很好
→
隐藏一部分今天的天气很 [MASK]
→
预测原内容目标:好
预训练
用大量无人工标注数据学习表示
下游任务
用已有表示完成分类、回归或生成
半监督学习(semi-supervised learning):同时利用少量有标签样本与大量无标签样本。
不同的输入数据与应用领域
机器学习从各领域的 $x$ 中学习规律,服务于不同任务。
图像与视频
↓
计算机视觉
Computer Vision · CV
目标识别 · 图像分割
语言与文本
这篇论文研究什么?从文本中提取信息
↓
自然语言处理
Natural Language Processing · NLP
翻译 · 问答 · 文本生成
语音与音频
↓
语音与音频处理
Speech & Audio Processing
语音识别 · 合成 · 分离
蛋白质与分子序列
M A L W M R L LP L L A L L A L氨基酸序列示意
↓
计算生物学
Computational Biology
结构预测 · 分子设计
领域决定数据与问题,机器学习提供学习模型的方法。
前沿应用:六个案例
① 蛋白质结构预测
蛋白质的功能与其化学组成、氨基酸序列及三维结构密切相关。
由氨基酸序列推定三维结构是生物学悬置半个世纪的问题。
1基因测序得到氨基酸序列
→
2预测三维结构序列 → 原子坐标
→
3推断功能活性位点、结合口袋
→
4下游应用药物设计、酶工程
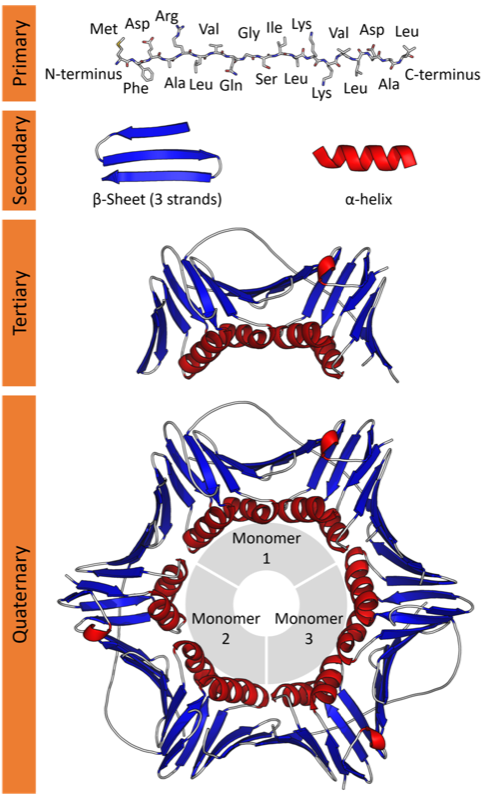
从序列到形状一级结构(序列)决定最终的三维折叠
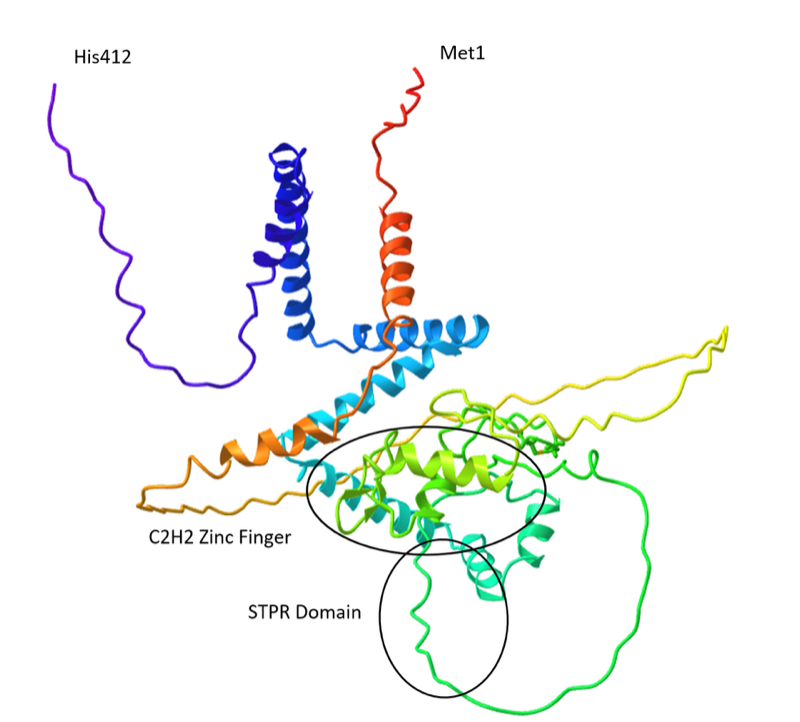
预测出的三维结构输入只有序列,输出是原子坐标
ML 替代了什么
- 第 2 步原先依赖实验测定(X 射线晶体学、冷冻电镜 cryo-EM)
- 单个蛋白耗时数月至数年,且大量蛋白无法结晶
- 现可在数分钟内完成,覆盖此前无法测定的绝大多数蛋白
本质上是什么学习问题
- 输入 x
- 氨基酸序列 + 同源序列比对
- 输出 y
- 每个原子的三维坐标
- 训练数据
- 已有实验结构数据库(约 20 万个)
- 关键设计
- 把"两个残基的相对位置"作为预测对象,
使模型对整体平移旋转不敏感
蛋白质结构预测与蛋白质设计相关工作获2024 年诺贝尔化学奖。
② 小分子药物发现
新药研发周期约 十年,投入达 十亿美元量级,九成以上于临床阶段失败。
1选靶点哪个蛋白该被抑制
→
2虚拟筛选10⁹ 级化合物库排序
→
3性质预测毒性、溶解度、代谢(合称 ADMET 性质)
→
4合成与实验只做排在前面的几十个
→
5临床试验人体
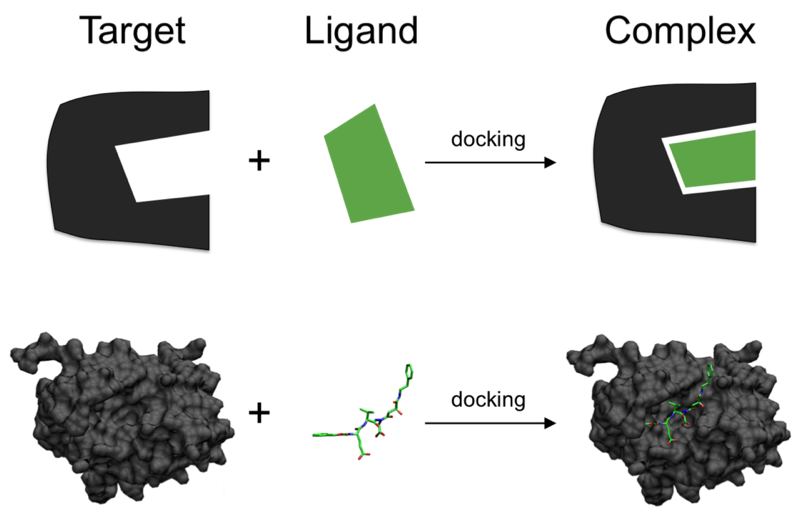
分子与靶点的结合模型要预测的就是这个结合有多强
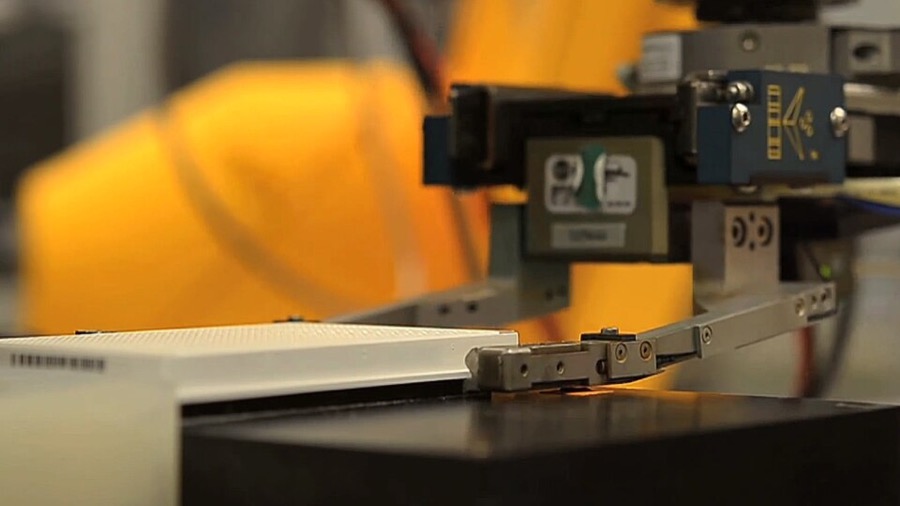
湿实验筛选机械臂一次几百孔,仍远不够穷举
靶点 · HIV · 血红蛋白
机器学习解决什么问题
- 承担第 2、3 步。类药分子空间约 1060,无法逐一实验
- 模型的任务是排序,选出最值得合成的数十个候选
- 第 4、5 步仍由实验与人体试验承担,药效与安全性只能由其判定
本质上是什么学习问题
- 输入 x
- 分子的图结构(原子为点,化学键为边)
- 输出 y
- 结合亲和力、毒性、口服吸收率……
- 难点
- 正样本极少;评价指标为前 k 个候选中的命中数
已有多个由 AI 参与靶点发现与分子设计的候选药物进入临床试验。
③ 个体化癌症疫苗 Moderna · Merck
1取材肿瘤组织 + 血样
→
2测序找出体细胞突变
→
3预测呈递哪些突变肽能被展示
→
4排序筛选最多 34 种新抗原
→
5合成 mRNA编码入一条链
→
6注射体内翻译出这些肽
呈递:细胞把抗原片段展示在表面,让 T 细胞识别。
机器学习承担第 3、4 步
- 每位患者具有不同的肿瘤突变
- V940 编码最多 34 种肿瘤新抗原
- 优先筛选可能激活免疫反应的候选
新抗原:肿瘤突变产生、可供免疫系统识别的蛋白片段。
学习任务
- 输入
- 肿瘤突变 + 患者免疫特征
- 输出
- 被呈递的概率
- 形态
- 排序,筛选候选新抗原
Moderna 与默沙东联合开发的个体化癌症疫苗 V940 与免疫治疗联用,在三期试验中较单用免疫治疗,
延长了黑色素瘤(一种皮肤癌)患者术后未复发、未发生远处转移的生存时间。
来源:Moderna 与默沙东联合公告,2026-08-19
④ 数值天气预报
传统做法
观测同化卫星、探空 → 初始场
解偏微分方程逐步推进,超算数小时
机器学习做法
观测同化这一步未变
神经网络推进学"当前场 → 6 小时后"
- 输入 x
- 当前全球网格上的气压、温度、湿度、风场
- 输出 y
- 数小时后同一网格上的同一批量
- 训练数据
- 四十余年的再分析资料(reanalysis)
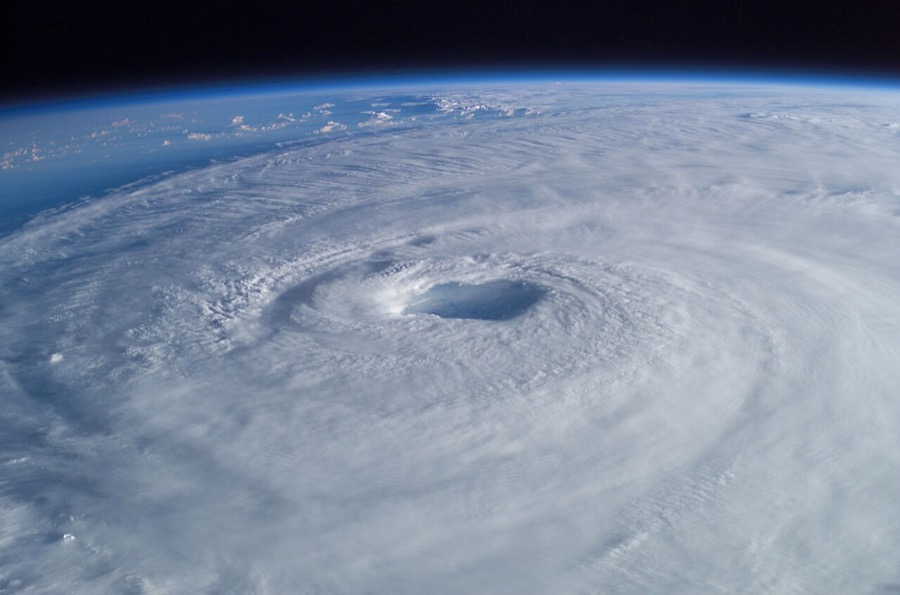
热带气旋路径预报提升最明显
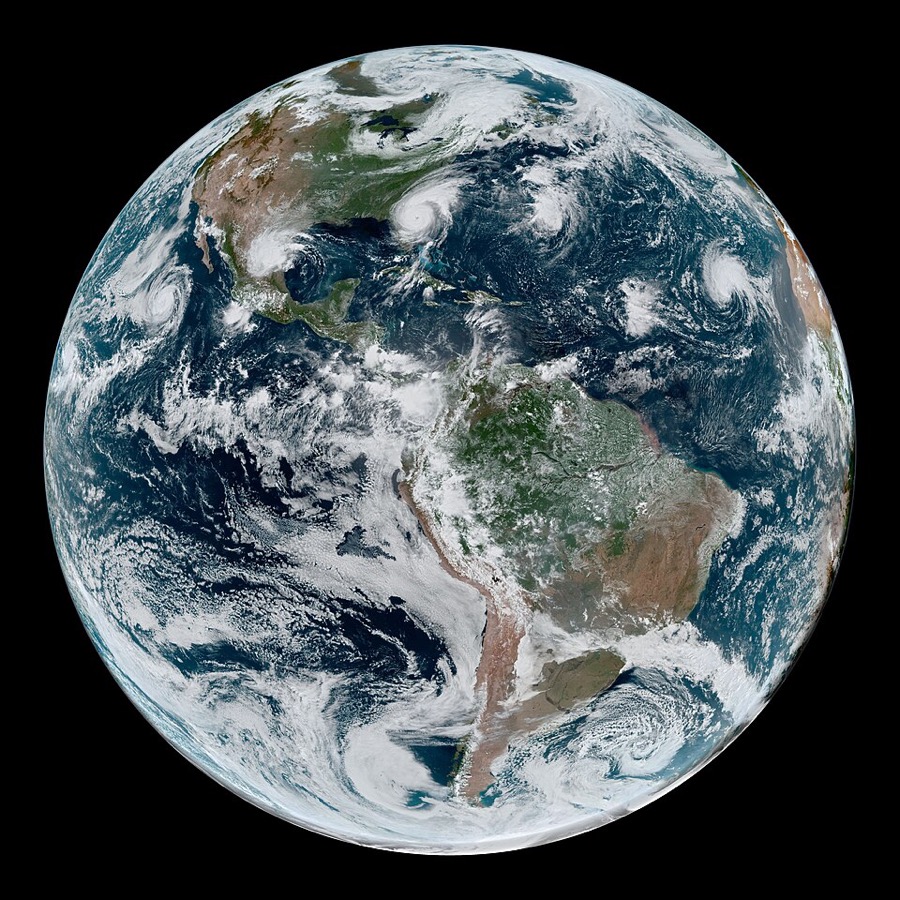
全球观测模型输入即此类网格
欧洲中期天气预报中心的机器学习预报 2025 年 2 月转入业务运行;
热带气旋路径等指标提升可达约 20%,算力低几个数量级。
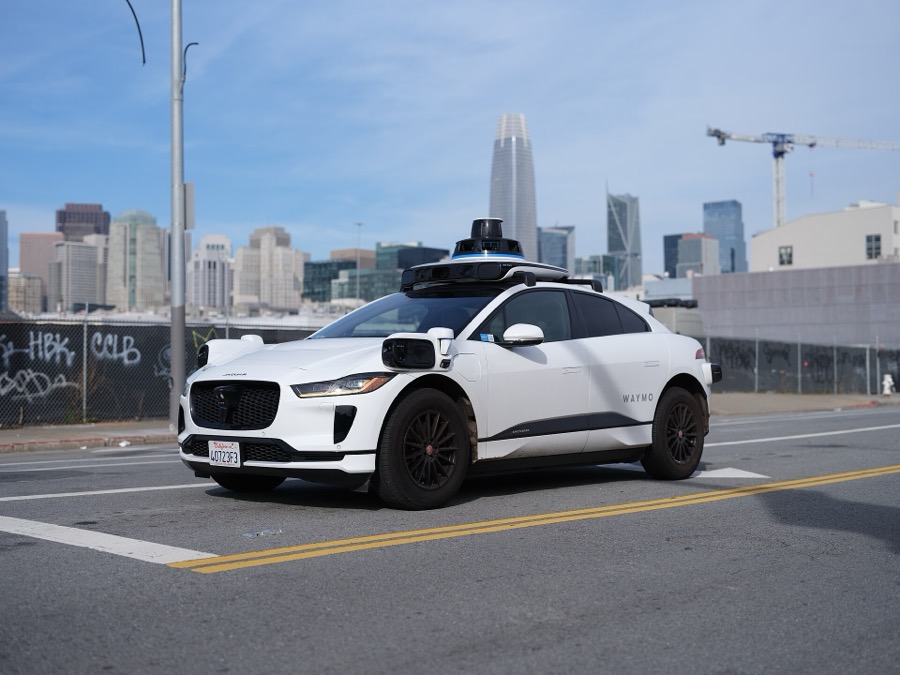
⑤ 自动驾驶:感知与预测
1传感器摄像头、激光雷达
→
2感知目标识别与定位
→
3预测未来运动轨迹
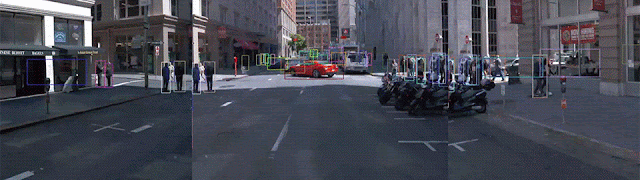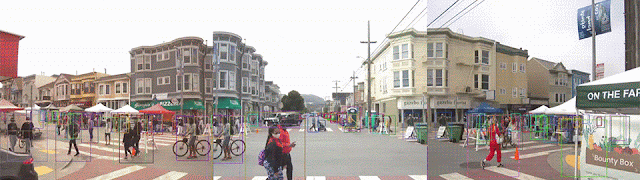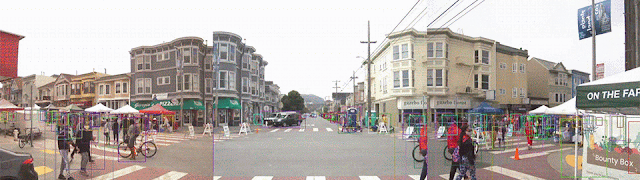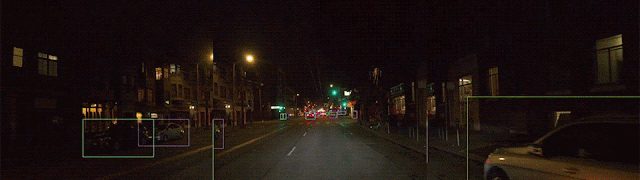
图像中的目标识别
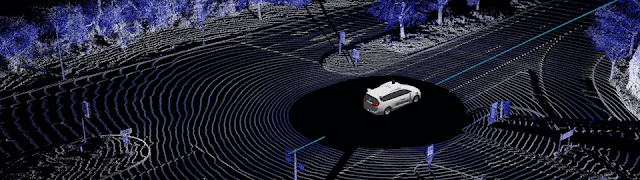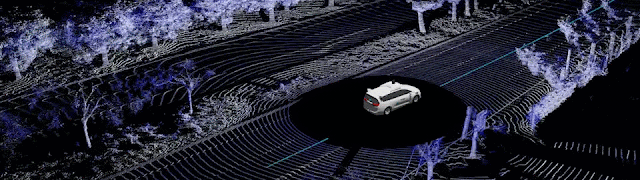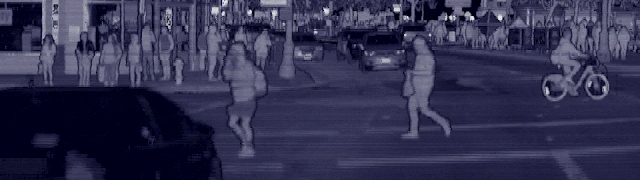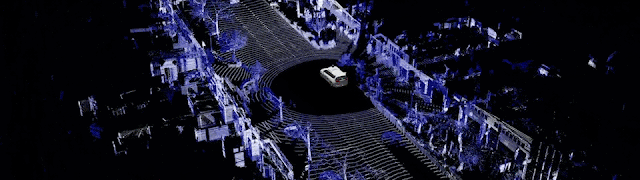
点云中的三维目标
计算机视觉(Computer Vision, CV)
| 环节 | 模型输出 |
|---|
| 感知 | 类别、位置、速度 |
| 预测 | 未来轨迹分布 |
Waymo · 多传感器融合
图与技术说明:Waymo Driver Handbook · Perception
⑤ 自动驾驶:决策与 planning
| 环节 | 输出 |
|---|
| 决策 | 让行、跟车、变道 |
| 规划(planning) | 位置与速度轨迹 |
| 控制 | 转向、加速、制动 |
强化学习(Reinforcement Learning, RL)
在仿真交互中优化驾驶策略
避碰 · 行驶进度 · 舒适性
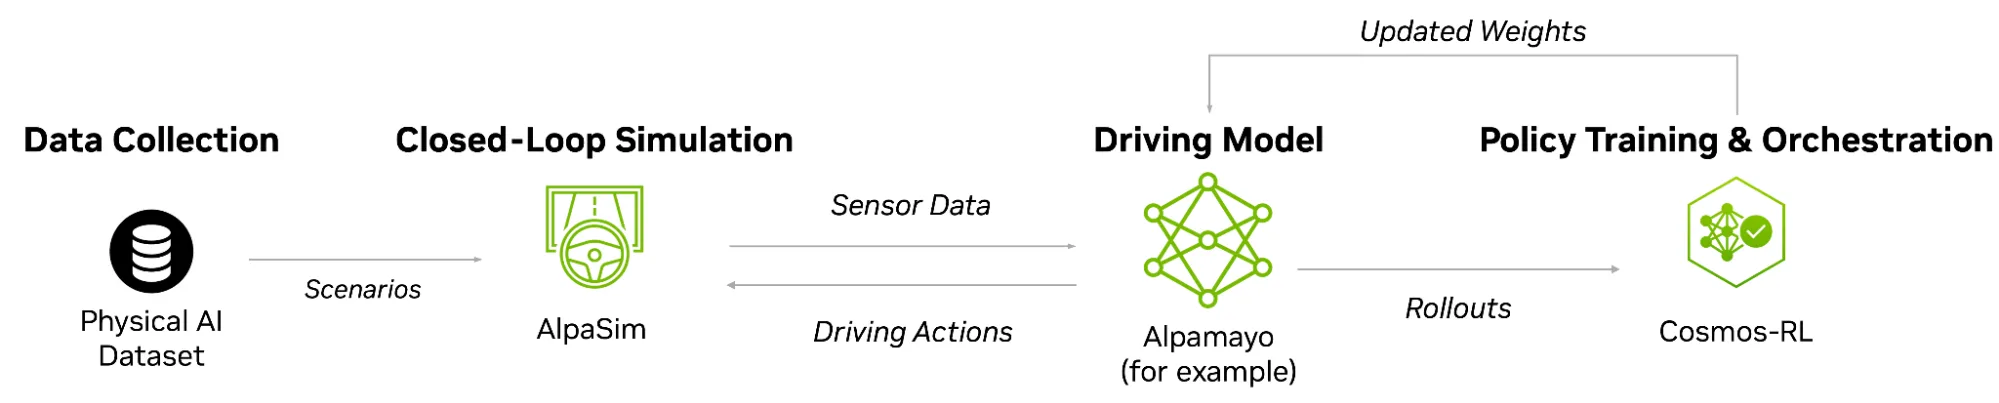
NVIDIA AlpaGym · 仿真交互与策略更新
图与案例:NVIDIA · 自动驾驶模型的闭环强化学习训练
⑥ 大语言模型
ChatGPT
OpenAI
Claude
Anthropic

Gemini
Google DeepMind

DeepSeek
深度求索
常见训练流程
预训练海量文本上预测下一个 token,无需人工标注
监督微调少量高质量问答示范
偏好对齐人工成对比较 → 奖励模型 → 强化学习
奖励模型依据人工偏好比较学习评分。
关键学习环节
| 训练目标 | 预测下一个 token |
| 训练方法 | 梯度更新参数 |
| 注意力机制 | 利用上下文信息 |
| 后训练 | 改善指令遵循与回答质量 |
什么问题适合用机器学习
适用性判断的四个方面:
| 条件 | 反例 |
|---|
| ① 存在模式 |
彩票号码、公平硬币的下一次结果 |
| ② 模式无法显式表述 |
判断闰年、算圆面积、求最短路 |
③ 有代表性的数据
训练分布 ≈ 部署分布 |
最常被低估的一条 |
| ④ 错误可承受 |
统计模型必然产生错误 |
能够凭经验做到,但是无法准确描述。
准确描述
形式逻辑
closed form(闭式表达)
补充阅读:Borwein & Crandall,
Closed Forms: What They Are and Why We Care(PDF)
什么问题不该用机器学习
| 情形 | 为什么 | 该用什么 |
|---|
| 问题可以精确求解 |
确定性算法具有正确性保证,机器学习仅给出统计意义上的近似 |
数值方法、组合优化 |
| 拿不到数据,或数据与部署场景分布差很远 |
训练分布与使用分布不一致时,验证集上的成绩不具参考价值 |
先解决数据问题 |
| 每个决定都必须能逐条解释、可追责 |
信贷拒绝、司法量刑、医疗诊断有法律和伦理要求 |
可解释模型,或作为辅助而非决策者 |
| 样本极少,且没有可用的先验知识 |
估计误差占主导,所得模型主要反映噪声 |
机理模型、专家规则 |
| 目标本身定义不清 |
如"提升用户幸福感"缺少可测量的 P,无法优化,亦无法判定成败 |
先把目标变成可测量的东西 |
| 系统的输出会反过来改变数据分布 |
推荐系统改变用户行为、交易策略被对手学习,训练时的分布不再成立 |
因果推断、在线学习、博弈论 |
最后一项的代价最大,且最易被忽视:模型上线后即成为未来数据的成因之一,
独立同分布(independent and identically distributed, i.i.d.)假设自此不再成立(第 2 讲)。
本讲小结
- 核心:从数据中学习模型
- 发展:学习规则、学习表示、迁移预训练模型
- 任务:预测、筛选、生成与决策
- 适用:规律可学、数据可用、效果可检验
延伸阅读
教材对应章节
- 周志华《机器学习》
第 1 章 1.1–1.2:基本术语与研究对象
- 李航《统计学习方法》
第 1 章 1.1–1.2:统计学习的定义与三要素
本讲案例的原始来源
| 案例 | 可核查的出处 |
|---|
| 蛋白质结构预测 |
2024 年诺贝尔化学奖公告(瑞典皇家科学院) |
| 个体化癌症疫苗 |
三期试验 INTerpath-001(NCT05933577)结果公告;
二期 KEYNOTE-942,The Lancet 2024 |
| 机器学习天气预报 |
欧洲中期天气预报中心(ECMWF)业务化运行公告,2025-02 |
| 自动驾驶 |
Waymo Driver Handbook;
NVIDIA AlpaGym 技术文档 |
第 1 讲结束
← → 翻页 · o 总览 · s 演讲者视图 ·
f 全屏 · 网址后加 ?print-pdf 可导出 PDF