第 10 讲
神经网络
可学习表示 · 前向计算 · 反向传播 · 卷积
特征工程与表示学习
CS229:非线性模型与可学习特征
神经元的加权求和
$$z=0.5\times2-1\times1+0.2=0.2$$
权重 $w$ 与偏置 $b$ 决定响应。
激活函数的形状
修正线性单元(Rectified Linear Unit, ReLU):$\max(0,z)$。
多层感知机的函数复合
$$h_1=\phi(W_1x+b_1),\quad \hat y=W_2h_1+b_2$$
多层感知机(Multilayer Perceptron, MLP);隐藏层输出作为新特征。
非线性层的作用
$$W_2(W_1x+b_1)+b_2=(W_2W_1)x+(W_2b_1+b_2)$$
中间加入非线性激活,扩大函数表示能力。
异或数据上的网络训练
合成异或(exclusive OR, XOR)数据;背景为当前模型 $p(y=1\mid x)$。
前向计算与损失
$$y=1,\qquad L=\tfrac12(\hat y-y)^2=0.125$$
反向传播中的链式法则
$$\frac{\partial L}{\partial w}=(\hat y-y)\,v\,\phi\prime(wx)\,x=-0.5$$
$$w\leftarrow w-\eta\frac{\partial L}{\partial w},\quad \eta=0.1:\ w=0.55$$
Rumelhart、Hinton、Williams,1986:反向传播与内部表示
训练循环
重复遍历训练集;用验证集选择设置。
卷积中的局部连接与权重共享
卷积神经网络(Convolutional Neural Network, CNN);示意特征层次。
卷积核的逐位置计算
$$z_{ij}=\sum_{a,b}K_{ab}X_{i+a,j+b}$$
人工像素矩阵;无填充、步长 1;卷积核为设定值。
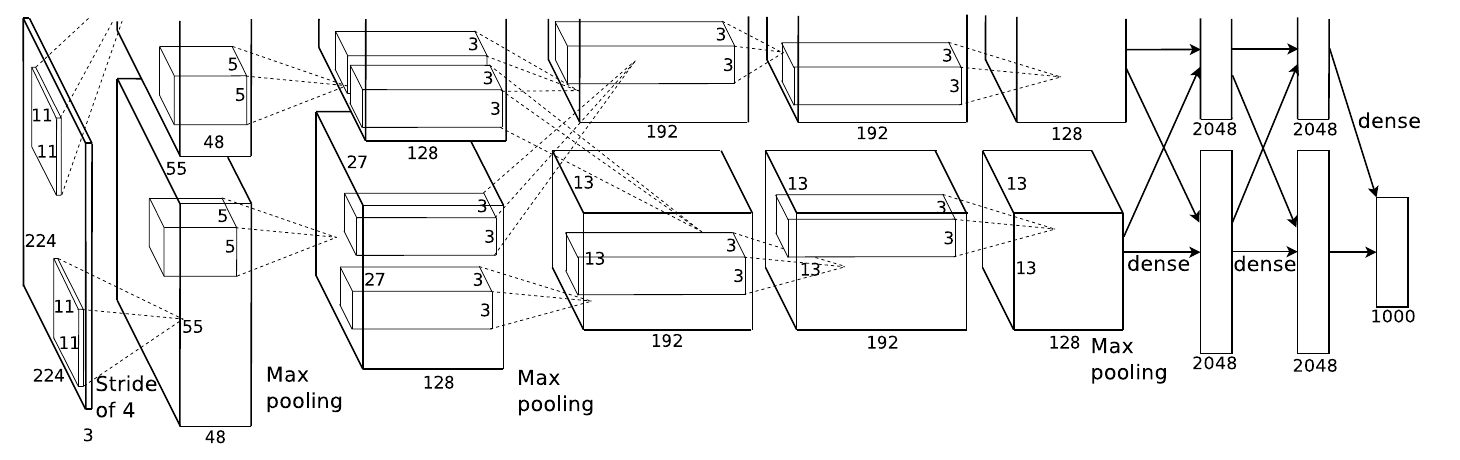
LeNet 与 AlexNet
| 代表工作 | 主要对象 | 方法特征 |
|---|
| LeNet-5 · 1998 | 手写字符 | 卷积、下采样、反向传播 |
| AlexNet · 2012 | 自然图像分类 | 深层卷积、ReLU、dropout |
LeCun 等,1998;Krizhevsky 等,2012,Figure 2(原图)
训练结果与泛化评价
| 现象 | 排查方向 |
|---|
| 训练损失难以下降 | 数据、梯度、学习率 |
| 训练好、验证差 | 容量、正则化、增强 |
| 部署数据变化 | 分布差异、重新评估 |
监督目标与表示的用途
第 10 讲结束
← → 翻页 · o 总览 · s 演讲者视图 ·
f 全屏 · 网址后加 ?print-pdf 可导出 PDF
 机器学习 · 研究生 第 10 讲 神经网络
https://kaizhao.net/teaching/shu-ml-grad