第 12 讲
图像无标注预训练
增强视图 · 对比学习 · 遮挡重建 · 下游迁移
自监督学习的训练信号
自监督学习(self-supervised learning):目标来自数据本身。
同图增强产生正对
增强规则定义模型应忽略哪些变化。
Chen 等,2020:增强组合与对比学习
同一图像的两种增强视图
程序生成的图像;像素差为实时计算,不代表语义相似度。
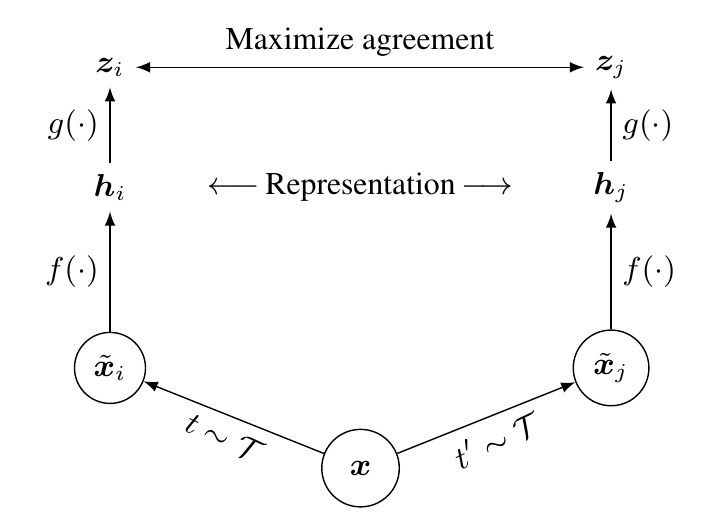
SimCLR 的编码器与投影头
编码器 f
图像 → 表示 h
投影头 g
表示 h → 对比向量 z
预训练同时更新 f、g;
下游通常保留 f。
Chen 等,2020,Figure 2(原图);视觉表示的简单对比学习框架(A Simple Framework for Contrastive Learning of Visual Representations, SimCLR)。
一个锚点的对比损失
$$L=-\log\frac{\exp(s_+/\tau)}{\exp(s_+/\tau)+\sum_j\exp(s_j^-/\tau)}$$
$s_+$:正对相似度;$s_j^-$:负对相似度;$\tau>0$:温度。
SimCLR:式 (1)
向量夹角、温度与对比损失
教学设定的二维单位向量;实时计算单个锚点损失。
MoCo 的队列与动量编码器
$$\theta_k\leftarrow m\theta_k+(1-m)\theta_q$$
He 等,2019 / CVPR 2020:Momentum Contrast (MoCo)
表示坍塌与约束
仅拉近正对
常量表示也能满足。
对比学习:负对提供区分约束。
自蒸馏:需专门的防坍塌设计。
DINO 的教师与学生
$$L=-\sum_k p_t(k)\log p_s(k)$$
Caron 等,2021:无标签自蒸馏(self-DIstillation with NO labels, DINO)
图块与位置编码
视觉 Transformer(Vision Transformer, ViT)处理图块序列。
图块数量与向量维度为结构示意;Dosovitskiy 等,2020 / 2021:Vision Transformer。
MAE 的非对称结构
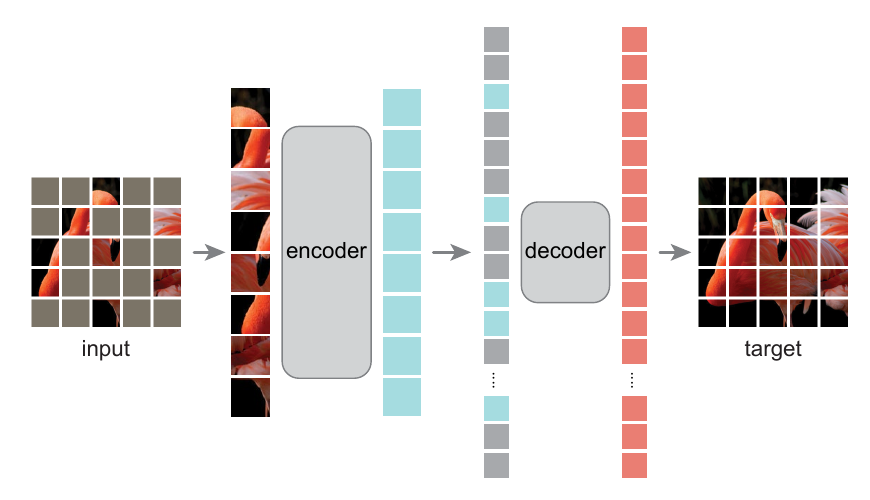
编码器处理可见块;解码器预测缺失块。
He 等,2021 / CVPR 2022,Figure 1(原图);掩码自动编码器(Masked Autoencoder, MAE)。
遮挡重建的输入、目标与损失
$$L=\frac1{|M|}\sum_{j\in M}\|\hat x_j-x_j\|^2$$
$M$:被遮挡图块集合;目标 $x_j$ 来自原图。
MAE:Reconstruction target
被遮挡位置的重建损失
$$L(c)=\frac1{|M|}\sum_{j\in M}(c-x_j)^2$$
合成灰度矩阵;常数预测器演示遮挡损失及梯度更新。
预训练后的两种迁移方式
线性探测(linear probing)与微调(fine-tuning)。
三类自监督目标的对应关系
| 方法 | 输入 | 训练目标 |
|---|
| SimCLR / MoCo | 同图增强视图 | 识别正对 |
| DINO | 同图不同视图 | 匹配教师分布 |
| MAE | 可见图块 | 恢复缺失像素 |
预训练目标塑造表示;下游任务检验表示。
预训练数据与迁移边界
背景偏差、重复样本与域变化会影响迁移。
第 12 讲结束
← → 翻页 · o 总览 · s 演讲者视图 ·
f 全屏 · 网址后加 ?print-pdf 可导出 PDF
 机器学习 · 研究生 第 12 讲 图像无标注预训练
https://kaizhao.net/teaching/shu-ml-grad