第 13 讲
语言模型预训练
token 表示 · attention · 掩码预测 · 自回归生成
文本自身产生预测目标
大型语言模型(Large Language Model, LLM);分词为教学示意。
token 化与嵌入向量
$$e_t=E[\mathrm{id}_t]+p_t$$
编号用于索引;向量参数承载表示。
attention 的查询、键与值
$$\alpha_j=\frac{\exp(q^{\mathsf T}k_j/\sqrt d)}{\sum_l\exp(q^{\mathsf T}k_l/\sqrt d)},\quad h=\sum_j\alpha_jv_j$$
Vaswani 等,2017:Scaled Dot-Product Attention
attention 权重与因果掩码
三 token、二维设定向量;实际计算 softmax 与加权和。
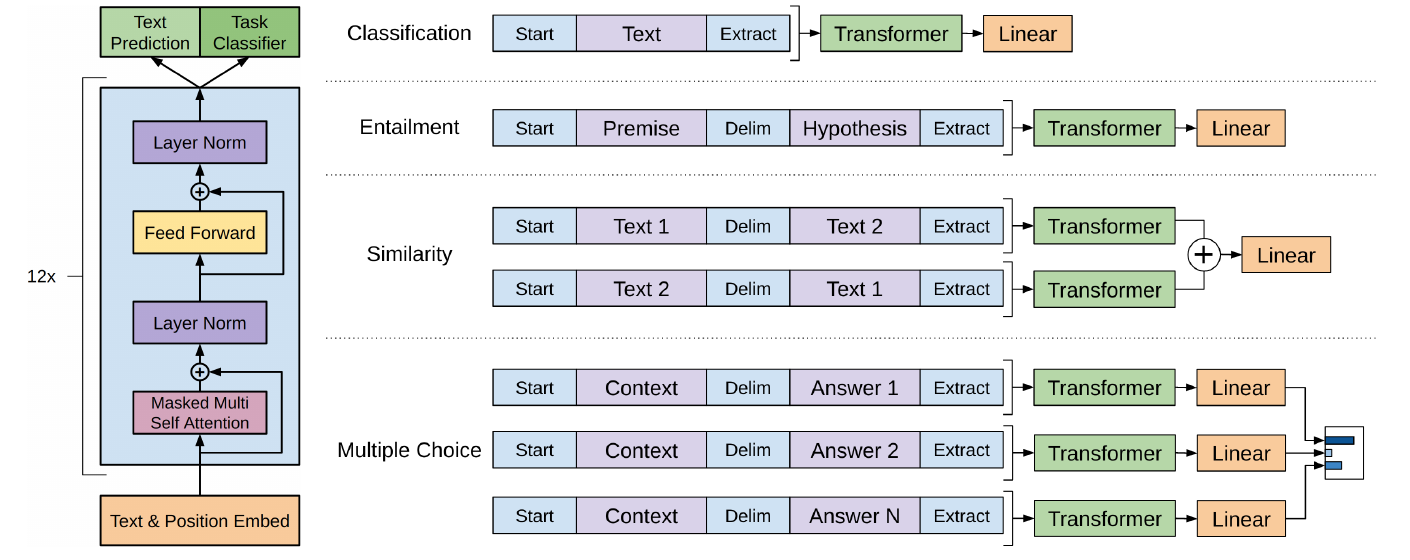
Transformer 块的结构
多头:多组查询、键、值并行计算。
Attention Is All You Need,2017
BERT 的双向预训练
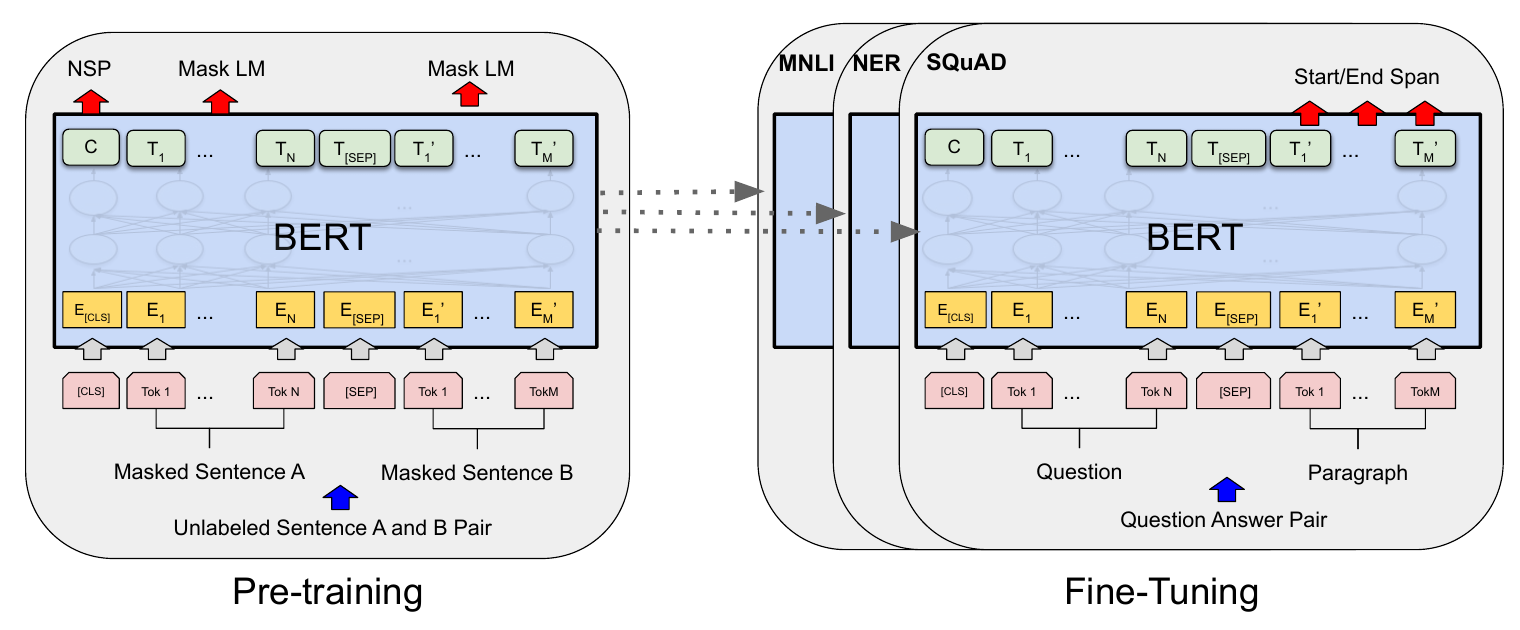
用左右上下文,预测被选中的原始 token。
Devlin 等,2018 / 2019,Figure 1(原图);双向 Transformer 编码表示(Bidirectional Encoder Representations from Transformers, BERT)。
掩码语言模型的训练目标
$$L_{\mathrm{MLM}}=-\sum_{t\in M}\log p_\theta(x_t\mid\widetilde x)$$
只在选中位置计算预测损失。
掩码语言模型(Masked Language Modeling, MLM);BERT §3.1
下一 token 预测的序列分解
$$p_\theta(x_1,\ldots,x_T)=\prod_{t=1}^{T}p_\theta(x_t\mid x_{
$$L=-\sum_{t=1}^{T}\log p_\theta(x_t\mid x_{
 机器学习 · 研究生 第 13 讲 语言模型预训练
https://kaizhao.net/teaching/shu-ml-grad